Le 18 novembre, AWS a lancé le routage interrégional des inférences SageMaker AI et présenté le cas d’une passerelle interne de Salesforce. Le service sélectionne des points de terminaison déjà déployés dans plusieurs régions et comptes. Salesforce maintient les requêtes soumises à une exigence de résidence dans la région d’origine et permet aux autres d’utiliser une région autorisée en cas de difficulté locale. L’intérêt est important lorsqu’une entreprise exploite déjà le même modèle dans plusieurs endroits aux capacités inégales. Encore faut-il savoir quelles requêtes peuvent être déplacées, qui réserve la capacité à l’arrivée et comment vérifier le parcours suivi. Cas Salesforce et AWS
L’essai donne une limite utile. Pendant une saturation, la latence a augmenté pendant plusieurs minutes sans que le trafic quitte la région. Des requêtes ont commencé à partir ailleurs après l’arrivée des erreurs. Cet exemple montre le partage de capacité selon des règles précises. Il soulève aussi la question du temps acceptable avant leur déclenchement. J’évaluerais le service comme un moyen de déléguer une partie du routage. L’entreprise garde la responsabilité des destinations, des points de terminaison, du rétablissement et de l’information des clients. Choisir un service pour décider d’une destination ne décide pas de ce que la requête peut contenir ni du moment où elle doit finir.
Les trente régions expliquent le problème, pas le déploiement#
L’équipe Agentforce Foundation dit servir des modèles dans plus de 30 régions avec de nombreux comptes AWS. C’est l’implantation de son service de modèles. La vérification du routeur a un périmètre plus étroit, et l’article présente un déploiement plus large comme une prochaine étape. La différence est essentielle à la lecture d’un cas client. Une entreprise présente dans beaucoup de régions peut expliquer un problème sans avoir essayé sa solution partout. Chez Salesforce, les pics et l’arrivée de nouveaux clients font manquer de capacité ici et en laissent ailleurs. Réserver dans chaque région assez de machines pour les pics simultanés peut coûter cher. Mutualiser une partie de la capacité est intéressant si le trafic et les destinations peuvent y participer.
La méthode traditionnelle consiste à maintenir le basculement dans l’application ou la passerelle. Salesforce dit que celle-ci utilisait des contrôles d’état, de nouvelles tentatives et des changements de région, avec une vision incomplète de la capacité au départ et à l’arrivée. L’équipe voulait aussi limiter les conséquences du report de charge. Confier des règles à un service géré réduit ce que chaque application doit maintenir et change la façon de tester les décisions. Le responsable doit demander ce que le fournisseur prend en charge, quelles règles restent dans l’entreprise et quels incidents il faut encore répéter. Ces responsabilités restent importantes même si un seul appel remplace plusieurs opérations.
Le lancement permet de comparer ce choix à l’achat de capacité brute. AWS annonce 32 régions commerciales pour l’inférence en temps réel et 25 pour l’inférence asynchrone. Ces nombres décrivent la couverture du fournisseur, distincte des régions de Salesforce et de son essai temps réel entre deux d’entre elles. Ils disent où vérifier la disponibilité sans créer de ressources dans le compte du client. Le déploiement part des modèles et régions que l’entreprise exploite. Une deuxième région qui ne dispose pas du bon modèle ou manque de place ne devient pas une réserve utilisable parce que son nom apparaît dans une proposition commerciale. Annonce de lancement AWS
Déterminer l’éligibilité avant d’attribuer de la capacité#
La passerelle interne de Salesforce vérifie la contrainte de résidence avant d’ouvrir un chemin plus large. Une requête qui doit rester dans une région ne reçoit qu’une destination locale. D’autres peuvent atteindre des points autorisés ailleurs. Les catégories réagissent donc différemment aux incidents. La première a moins de destinations et éventuellement moins de capacité disponible quand sa région manque de ressources. La seconde profite d’un débordement régional. Un seul indicateur de disponibilité peut masquer le cas des clients sans destination de secours autorisée. L’acheteur doit connaître le service possible pour chaque catégorie.
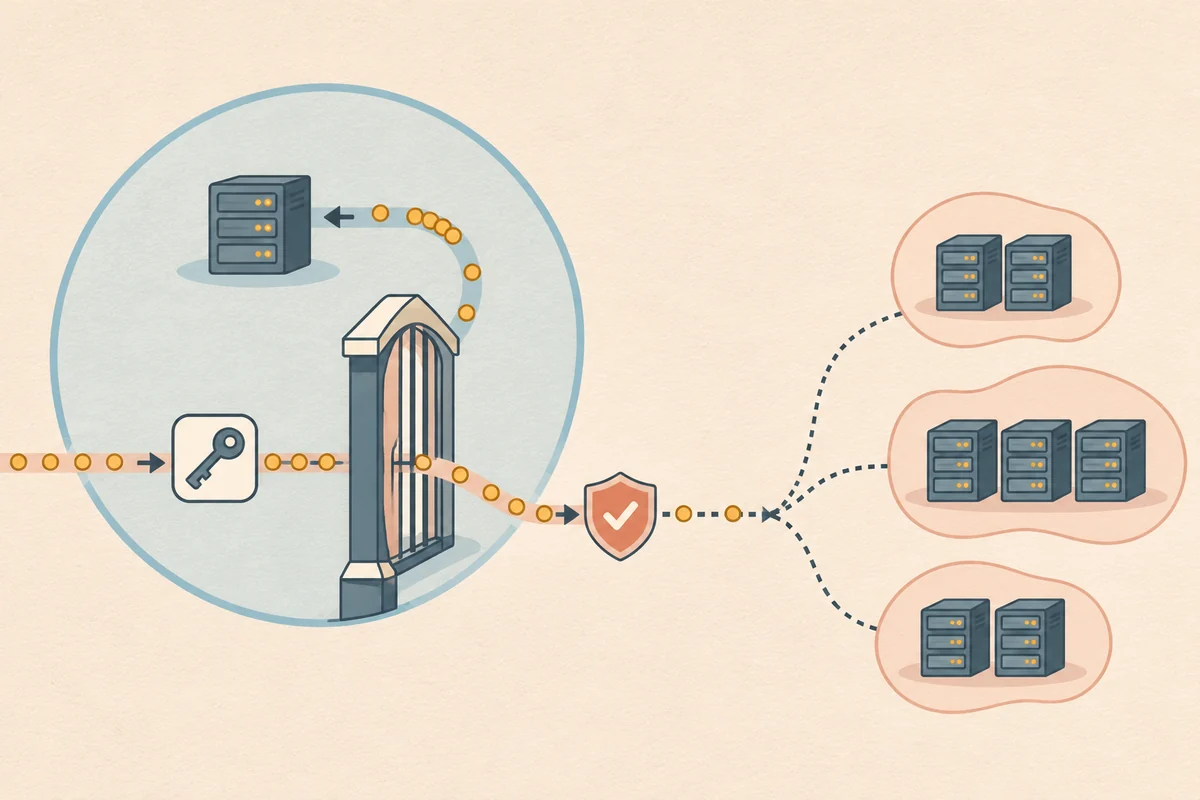
Une règle d’entreprise ne sort pas d’un menu de sélection des régions. Un engagement peut préciser quelles informations ou quelles opérations restent à l’intérieur d’un périmètre. L’équipe peut alors construire la liste des destinations et définir le comportement lorsque le service local échoue. Pour la même région, deux métiers peuvent avoir des conditions différentes. Un service traite des conversations de clients, un autre des exemples agrégés et autorisés ailleurs. Le responsable doit pouvoir rattacher une requête à la bonne règle et garder une trace de cette décision. La gestion de capacité est plus acceptable quand le client peut expliquer la limite qui l’entoure.
Il faut aussi regarder une requête dont les informations d’éligibilité manquent ou se contredisent. L’application doit savoir quoi faire si elle ne peut pas déterminer le parcours permis. Pour une charge, il peut être adapté de rester sur place ou d’attendre. Une autre peut avoir une liste validée plus large. La décision découle des engagements et non du volume de trafic du moment. Ces situations se présentent lors d’un lancement ou d’un changement de données. Le cas de Salesforce est intéressant parce que la passerelle garde la règle métier avant de déléguer les autres décisions. L’acheteur peut indiquer ce qui doit demeurer dans sa propre passerelle.
La destination doit disposer de son propre budget de capacité#
Un routeur envoie les requêtes aux destinations que le client exploite déjà. Il ne déploie pas le modèle, ne copie pas ses fichiers et ne fournit pas de nouvelles machines. Le propriétaire du point de terminaison décide donc de la capacité, même si un tiers opère le routeur. Si une région occupée accepte toutes les requêtes d’une voisine, l’incident peut se propager. AWS offre un plafond facultatif sur le trafic interrégional des points temps réel pour laisser de la place aux appels locaux. Il a de l’intérêt si les groupes peuvent convenir de la capacité à partager, puis mesurer ce que le routeur fait lorsque le plafond est atteint.
Le budget comporte deux parts. Il y a ce que la destination utilise lors de ses propres pics et ce qu’elle peut prêter. Les pics des deux régions peuvent être indépendants ou coïncider. Une région souvent calme peut être une bonne réserve pour un pic défini. Elle aide moins lorsque les deux sont touchées. Le compte rendu prévoit encore d’évaluer le comportement en cascade au plafond avant d’étendre le déploiement. Il faut observer le fonctionnement normal et le cumul le plus gênant avant de définir une nouvelle garantie avec des ressources partagées.
L’accès entre comptes ajoute une responsabilité. Salesforce décrit une règle de destination qui autorise un routeur nommé. Le propriétaire garde la décision sur l’accès. Il a besoin de connaître les responsables, les parcours approuvés et les conditions pour modifier l’autorisation. En cas d’incident, une personne doit pouvoir expliquer le volume que la destination peut accepter et les conséquences pour ses clients. Un service commun simplifie les appels. Il laisse en place les accords entre ceux qui fournissent des moyens et ceux qui les utilisent. Documentation AWS sur la protection des données du routeur
Lire les temps de Salesforce comme une suite d’observations#
Dans l’essai décrit, l’équipe a saturé le point de terminaison d’Oregon et observé les appels d’une sonde séparée. Pendant environ cinq minutes de saturation locale, la latence médiane de la sonde est passée de 0,2 seconde à quelque 45 à 58 secondes et le trafic est resté en Oregon. La latence seule ne déclenche pas le déplacement. Lorsque le délai d’attente dans le conteneur a commencé à produire des erreurs, les premières requêtes ont atteint l’Ohio environ deux minutes plus tard. En une minute supplémentaire, environ 78 % du trafic de la sonde y était servi. Cette chronologie montre pourquoi le déclencheur compte autant que la présence d’une réserve. Présentation du fonctionnement du routeur par AWS
Après le transfert, la médiane déclarée est revenue à 0,2 seconde et le trajet entre régions ajoutait moins de 100 millisecondes à la médiane dans cette configuration. Le trafic est revenu progressivement en environ dix minutes après rétablissement. Selon le compte rendu, aucune erreur n’a été enregistrée par la sonde pendant le basculement et le retour. Le résultat concerne cette sonde. Il est distinct des erreurs du point saturé et de ce qu’une autre charge pourrait rencontrer. La capacité et les délais varient selon les régions. Il faut choisir une partie de l’expérience à refaire plutôt que de mettre ses chiffres dans chaque nouvel engagement.
Pour l’activité, l’attente avant le transfert compte parfois davantage que la rapidité après. Une application interactive peut perdre des utilisateurs qui attendent une minute. Un traitement par lots peut tolérer un rétablissement plus lent et préférer éviter un transfert sur la seule base d’un temps d’attente. Le responsable produit doit choisir ce que l’utilisateur voit ou peut faire pendant l’évaluation de l’état. L’essai montre comment commence et finit cette période. L’application conserve la responsabilité de ce que vivent les personnes pendant ce délai.
Conserver la destination et la raison du choix#
Salesforce explique que la passerelle enregistre avec l’identifiant de requête le point qui a répondu et la raison du choix. AWS fournit aussi des mesures par destination dans CloudWatch. Ces deux éléments distinguent l’activité locale normale des requêtes déplacées après des erreurs. Le budget d’observation doit aider à voir ce que le système a fait et si la règle d’entreprise a tenu. Le responsable de l’application a besoin de retrouver le lieu du traitement et la personne à contacter lorsqu’un résultat est inattendu. Guide AWS de suivi du routage
Enregistrer le lieu et la raison ne demande pas de montrer largement le texte envoyé. L’identifiant, la destination approuvée et le motif permettent d’enquêter, avec un accès limité aux précisions nécessaires. Les traces exigent encore des règles de conservation et un responsable. On peut choisir comment vérifier leur exactitude avant d’avoir à comprendre un incident. Utiliser des exemples autorisés et comparer les journaux de départ et d’arrivée avec la règle documentée. Un tableau utile décrit les demandes et les erreurs. Une bonne trace permet de retrouver la décision sur un cas particulier plus tard.
Les versions des modèles comptent aussi dans ces traces. Après une mise à jour, une région peut utiliser une autre version, une autre image de conteneur ou d’autres fichiers. Le routeur peut y envoyer la requête sans rendre les deux déploiements équivalents. Si le résultat change, un rétablissement apparent peut cacher une dégradation de qualité. L’équipe peut comparer les réponses à des exemples approuvés avant d’autoriser le débordement. Elle peut consigner la version et décider du traitement d’un retard de déploiement. Le service fournit une destination. La société décide quelles destinations peuvent répondre à la même demande.
L’absence de supplément pour le routeur modifie une ligne du budget#
L’annonce indique que le routage ne coûte pas de supplément. Les points de terminaison et les mesures CloudWatch restent facturés aux tarifs habituels. L’organisation doit ajouter la réserve, le temps pour valider des modèles dans plusieurs régions, la surveillance, l’aide et les autres coûts de son architecture. L’investissement est plus intéressant si des requêtes utilisent des ressources qui resteraient autrement inactives. Il l’est moins si la région d’arrivée doit réserver presque autant qu’en cas de redondance locale et si les contrôles ajoutent du travail. Les chiffres de publication permettent de commencer une comparaison. Ils ne forment pas la prochaine facture de l’entreprise.
On peut comparer le coût d’une réponse réussie dans un délai acceptable. Relever les destinations en temps normal, les essais répétés et la capacité locale encore nécessaire. Les finances peuvent alors rattacher les coûts aux catégories qui profitent du dispositif. Une charge obligatoirement locale peut avoir besoin d’un investissement distinct et ne doit pas être incluse dans des économies qu’elle ne peut utiliser. Une réserve commune est utile lorsque les pics sont décalés. S’ils coïncident, chaque région peut encore avoir à réserver des ressources pour le même mauvais après-midi. Le service choisit comment on les utilise. Le client continue de choisir combien acheter.
Le budget d’exploitation comprend aussi la personne qui peut intervenir. Confier le routage au fournisseur peut retirer du travail répété dans plusieurs applications. L’équipe doit ensuite comprendre les motifs, le suivi et les moyens d’agir sous pression. Sans essai préalable, elle risque d’échanger le temps de développement contre une enquête sur une décision plus éloignée. Si les responsables voient les requêtes se déplacer, savent gérer les échecs et respectent les engagements, le travail peut diminuer. L’acheteur peut comparer les rôles du déploiement initial, des vérifications courantes et de la gestion des destinations avec la méthode actuelle.
Définir le service acceptable pendant et après le ralentissement#
Un engagement utile précise le résultat disponible lorsqu’une requête autorisée dure plus longtemps que prévu. Une page interactive peut montrer un état honnête et une autre action si la tâche ne peut pas finir rapidement. Un processus périodique peut attendre la fin ou un échec enregistré. Ce sont deux manières d’encadrer le même routage. Un responsable peut mesurer le délai pour l’utilisateur, le sort des tentatives déconnectées et le lien entre la réponse et la requête d’origine. Un graphique de rétablissement ignore ces éléments si l’application ne les relève pas.
Le périmètre des nouvelles tentatives a aussi son importance. Selon le cas, le routeur peut retenter une fois certains échecs quand le modèle n’a pas été exécuté. La passerelle Salesforce n’ajoute pas de nouvelle tentative sur ce parcours. Il faut savoir quel essai a rendu le résultat et si les clients en lancent d’autres. Répéter les opérations augmente la pression sur la destination précisément lorsque plusieurs régions l’utilisent. Pour un client soumis à des contraintes de délai ou de volume, la qualité tient à l’obtention d’un résultat sans duplications ni attentes qui s’accumulent. Cela dépend du fournisseur et des réglages de l’application.
Les régions doivent aussi s’accorder sur le retour à la normale. Lorsque le point principal redevient sain, le service déplace les appels progressivement vers leur région. La destination peut encore partager ses moyens pendant ce mouvement. Elle doit voir si la charge et le coût habituels reviennent et savoir qui peut suspendre l’élargissement si le prochain incident se présente autrement. Avant l’exercice, les équipes peuvent convenir de qui observe le départ, de qui observe l’arrivée et de qui prévient le produit quand l’essai est terminé. Il faut organiser ces rôles même sans intervention manuelle sur les requêtes.
Il faut également convenir du cas où les deux points manquent de capacité. Chaque équipe peut nommer la part qu’elle accepte de partager et les étapes à suivre lorsque la limite est atteinte. Un plafond bas protège le service local et laisse moins de moyens au demandeur. Un plafond élevé peut résoudre un incident et ralentir un autre groupe. Il faut tester les deux cas et définir qui donne son accord à une modification. Le rétablissement d’une application ne doit pas masquer une dépense à l’arrivée. Un choix documenté peut être revu si les usages changent après un lancement.
Un essai limité doit prévoir des situations où les requêtes restent sur place#
Le pilote peut partir d’un modèle et de deux points déjà situés dans des régions autorisées. Utiliser des données de test admises aux deux endroits, comparer les résultats et régler la part de trafic que chaque point accepte. Simuler la perte du service local dans un environnement d’essai et vérifier la destination des demandes éligibles. Essayer aussi une charge nécessairement locale pour vérifier que les erreurs ne mènent pas à un transfert interdit. L’exercice doit comprendre le manque de capacité partout et le retour d’un point. Il s’agit de comprendre les choix que l’organisation peut gérer autant que de voir réussir un transfert.
Avant d’étendre l’usage, il faut garder visibles la durée de dégradation, les taux d’erreur et le retour, ainsi que l’expérience des utilisateurs habituels de la région d’arrivée. Les conditions doivent rester attachées au résultat. Le responsable doit savoir comment suspendre le routage élargi et ce que voit le client quand il ne reste aucune destination valable. Le service mérite un essai en présence de charges inégales et de plusieurs déploiements utiles. Mon avis changerait si l’essai montrait des ralentissements répétés avant le basculement, une pression sur les utilisateurs de la destination ou l’incapacité de montrer où est restée une demande protégée. Ces résultats valent plus qu’une connexion réussie en démonstration.
L’essai de Salesforce et l’annonce d’AWS montrent comment des capacités libres peuvent être partagées volontairement. Les décisions liées à l’usage restent visibles avant et après l’appel au routeur. L’entreprise approuve les catégories et les destinations, les équipes fournissent les points et quelqu’un examine les traces après un changement. Ces responsabilités combinées à un service géré peuvent simplifier l’exploitation. Le déploiement plus large se justifie quand on peut vérifier que les requêtes ont respecté les engagements de destination et de délai.