Dans sa publication technique du 18 novembre, Meta explique comment une amélioration passe d’un modèle de classement publicitaire à un autre. Selon son estimation, les agents ont pris en charge plus de 60 % de ce travail depuis qu’ils participent à son exécution en mars. L’entreprise rapporte que chaque ingénieur peut traiter environ trois fois plus d’adaptations. Pour une sélection de combinaisons, la consommation médiane de calcul d’entraînement se situe autour du quart de la référence précédente. Meta estime les économies de calcul à plus de 45 millions de dollars d’ici la fin de l’année. Pour un acheteur de logiciels d’automatisation, il faut commencer par regarder ce qui a été défini avant de mesurer. L’unité est l’adaptation d’une technique précise à un modèle précis. L’entreprise a déjà un moyen de dire si ce travail mérite d’être mis en production. Publication technique de Meta de novembre
Le choix le plus facile à transposer consiste à placer l’automatisation près d’une décision répétée, à lui donner accès aux essais passés et à déterminer qui peut autoriser la mise en production. Chez Meta, la question récurrente est de savoir si une amélioration trouvée quelque part peut servir à un autre modèle dans ses propres contraintes. Il faut encore des preuves et un ingénieur doit décider où consacrer du temps. Une entreprise qui dispose déjà de ces éléments peut mesurer le travail utile que les agents l’aident à terminer. Celle qui débat encore des critères d’un bon résultat trouvera d’abord davantage de propositions à examiner. La qualité du processus de déploiement donne son sens à la cadence.
Une amélioration doit être vérifiée dès que son environnement change#
Meta exploite des modèles de classement destinés à différents produits et objectifs publicitaires. Un modèle peut avoir ses propres données, variables, limites de coût en production et choix d’architecture. Un changement d’entraînement peut en améliorer un tout en augmentant le coût d’un autre ou en exigeant une variable qui manque. L’entreprise peut partir d’une idée qui a fait ses preuves dans un contexte, choisir des cibles, adapter la technique, vérifier l’effet et décider s’il faut l’exposer à un trafic réel. Les équipes qui entretiennent une gamme de produits connaissent ce travail. Les ressources rares sont les personnes qui comprennent pourquoi le changement précédent a fonctionné et disposent du temps nécessaire pour le transmettre avant l’arrivée du suivant.
Distinguer la découverte du déploiement aide à bien comparer. La présentation de mars du Ranking Engineer Agent portait sur la formulation d’hypothèses et la conduite d’expériences pour de nouvelles idées. Le texte de novembre examine la diffusion d’une technique prometteuse vers d’autres modèles. Un travail cherche un changement qui vaut un essai. L’autre découvre où il peut être repris. Les deux peuvent durer des jours et profiter d’un suivi manuel moins fréquent, mais les références et les résultats attendus diffèrent. Pour choisir un pilote, un responsable doit préciser le travail choisi. Demander si un agent peut améliorer le classement sans préciser la tâche laisse trop de place à une réinterprétation du résultat. Présentation de Meta sur les expériences de mars
La durée d’attente d’un changement a aussi une valeur économique. Dans un système qui évolue vite, une amélioration n’a qu’une période limitée pour produire un effet. Un modèle de remplacement ou une priorité de produit différente peut dépasser une adaptation encore en file. Une publication plus rapide vaut par sa capacité à atteindre les modèles qui ont le plus à gagner pendant que l’amélioration est utile. Le choix de ces modèles compte autant que le volume de travaux ouverts. On peut évaluer un pilote en suivant le temps nécessaire à une adaptation valide pour arriver en production, les informations disponibles au moment de fixer la priorité et les raisons pour lesquelles certains modèles ont été laissés de côté.
Les modèles types partagés regroupent plusieurs petites décisions#
Un autre article technique de Meta décrit ses modèles types standardisés. Ils donnent à des groupes de modèles des choix communs d’architecture, d’entraînement et de mise en service. Les ingénieurs testent un ensemble représentatif et peuvent améliorer le modèle type avec ce qu’ils apprennent. Une conception commune donne aussi à un agent un point de départ pour identifier les réglages qui ont des chances de marcher. Tester des configurations incompatibles une par une peut consommer beaucoup de capacité même avec un agent efficace. L’entreprise précise que les équipes conservent une logique particulière quand elle est nécessaire. Le modèle type est utile s’il s’appuie sur de vraies ressemblances et rend visibles les divergences qui restent. Présentation des modèles types par Meta
Une autre entreprise peut chercher un équivalent sans posséder des dizaines de modèles publicitaires. Pour adapter un système de rapports à plusieurs bureaux, une équipe peut trouver des schémas et des règles de sortie communs. En révisant une prévision sur différents marchés, elle peut constater que quelques exigences de production reviennent. Ces points communs rendent un test représentatif possible et indiquent les différences qui justifient un essai propre. Il faut d’abord décrire le travail. Avec une base connue, l’équipe peut dire si la nouvelle proposition retrouve simplement un résultat acquis et si l’économie d’une expérience séparée est justifiée.
Cette mutualisation a des limites. Un modèle qui représente beaucoup de recettes ou qui répond à des contraintes strictes peut mériter une évaluation plus fine. Meta affirme que les spécialistes continuent à diriger les adaptations propres aux modèles qui génèrent le plus de revenus, tandis que les agents apprennent à leurs côtés et exécutent une partie du travail. Une autre organisation peut réserver l’intervention directe d’un expert aux cas où une régression coûterait cher. Il s’agit d’une allocation volontaire du temps d’ingénierie. La décision sur les standards peut préciser qui utilise le processus commun, quelles preuves ouvrent l’accès à d’autres groupes et qui décide que le risque d’un cas justifie encore un traitement propre.
Un premier tri change l’usage du budget#
Meta présente d’abord des adaptations possibles et leur attribue une priorité selon le bénéfice attendu. Une candidature utile associe un changement précis à un modèle qui pourrait le recevoir et à une raison de croire à cette association. Le choix influence tout le programme, puisqu’un couple qui n’apparaît jamais n’aura aucune chance de montrer son intérêt. Si toutes les associations plausibles sont proposées, l’entraînement et l’examen peuvent être saturés par des tentatives de faible valeur. Meta dit mesurer combien de modèles choisis reçoivent finalement la technique ainsi que la part des modèles viables qui ont été repérés. Les deux mesures répondent à des questions différentes. Ensemble, elles peuvent révéler une amélioration d’efficacité due à un périmètre devenu trop étroit.
Cette étape tire parti des traces laissées par les expériences. Meta décrit comment les essais anciens et les caractéristiques du modèle aident à choisir un point de départ, à modifier les essais suivants et à arrêter les entraînements peu prometteurs. Le patrimoine de l’entreprise, ici, est un ensemble de décisions que l’on peut comparer. Les essais sans résultat doivent en faire partie. Un catalogue de seules réussites cache de l’information et peut pousser les agents à répéter un travail coûteux déjà tenté par une personne. D’autres équipes peuvent collecter les raisons des refus en plus des interventions acceptées. Cela aide les personnes et les logiciels à séparer une mauvaise candidature d’un mauvais test.
Un agent peut également accorder trop de confiance à un historique incomplet. Un résultat obtenu dans une version du modèle peut perdre sa pertinence après un changement de données ou d’infrastructure. Si les anciennes performances deviennent la seule façon d’établir les priorités, l’équipe peut passer à côté du même nouveau cas à répétition. Un bon processus permet de dater les résultats, de garder un motif pour chaque décision et de revoir les cas qui n’ont pas été sélectionnés. Une équipe qui exécute ce travail régulièrement peut réserver quelques vérifications à des candidats moins bien classés. Elle peut ainsi découvrir un type de travail utile qui échappe à ses critères avant que l’omission devienne une habitude.
Le travail humain, le calcul et les délais se comptent séparément#
L’annonce décrit davantage de temps d’ingénierie disponible et une utilisation plus ciblée du calcul d’entraînement. Les 60 % sont l’estimation de la part des adaptations prises en charge par les agents. Le facteur trois désigne la quantité d’adaptations que peut traiter un ingénieur. La réduction médiane de calcul vient de combinaisons choisies. Les économies de fin d’année restent la projection de Meta. Les quatre indicateurs peuvent être encourageants à la fois. Chacun a son périmètre et sa référence. Une équipe qui n’a pas estimé les coûts d’installation, d’examen et de maintenance ne peut déduire le rendement de son programme du seul calcul d’entraînement.
Une comparaison de coûts attribue aussi les dépenses aux candidats abandonnés et au travail qui suit l’essai. Une méthode peut éviter un test cher grâce à un tri léger et réclamer davantage d’examen des propositions restantes. Une autre peut avoir une expérience plus coûteuse et réduire les reprises ou accélérer l’approbation. Il faut relever la planification et l’exécution, les personnes, le calcul et le suivi. Si le travail répété est d’adapter et de lancer une amélioration éprouvée, on peut rapporter les dépenses aux adaptations acceptées selon les mêmes critères dans l’ancien et le nouveau processus. Compter toutes les tentatives à part permet de voir quelles économies viennent des arrêts anticipés.
La durée compte aussi, car dépenser moins et livrer plus vite sont deux résultats différents. Un ingénieur peut être disponible pour examiner plus de changements pendant que la file de calcul ou de données s’allonge. Le volume d’expériences par personne peut mériter d’être signalé. Le responsable a aussi besoin de savoir si les dates de livraison changent. Meta dit que la diffusion à tous les modèles compatibles peut dépasser un an et vise trois mois, avec un objectif d’environ cinq fois le débit de bout en bout. Ce sont des objectifs. Une autre entreprise peut noter les temps d’attente dans les files et mesurer laquelle doit changer pour que le résultat arrive plus tôt.
Les critères de mise en production doivent exister hors du rapport de l’agent#
Meta indique que les techniques candidates passent des tests prédictifs et des limites de coûts avant les expériences en ligne. Les modèles réduits permettent un premier tri moins coûteux. Des modèles complets représentatifs valident les candidats restants avant généralisation. Meta exige également une amélioration statistiquement significative dans les tests en ligne selon ses critères, puis une approbation humaine. Chaque étape répond à une question. Un petit essai décide si le couple mérite d’autres ressources. Un test représentatif vérifie la persistance de l’effet dans des conditions plus réalistes. L’essai en ligne et l’approbation décident si l’activité et les utilisateurs seront exposés au changement.
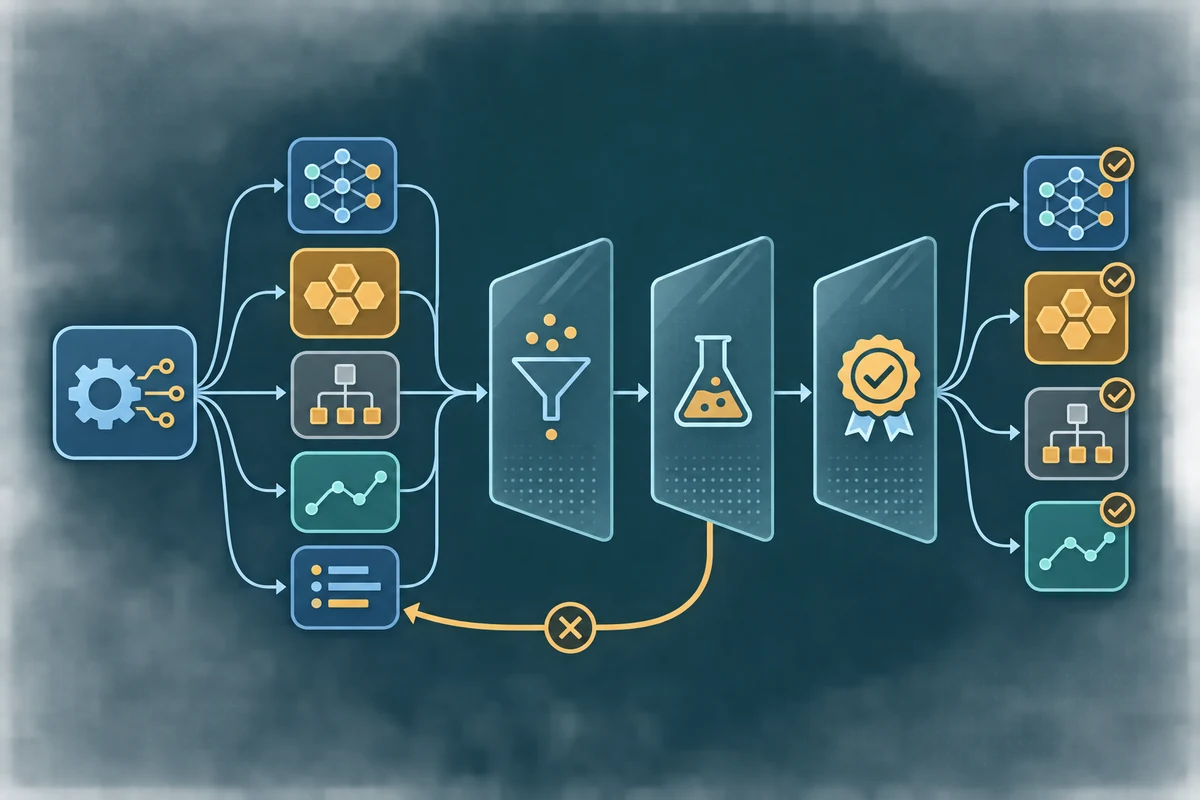
Cela a une conséquence directe pour les pilotes. Le responsable doit avoir des preuves qui restent convaincantes si la personne qui rédige le rapport n’a jamais lu l’explication de l’agent. Une équipe qui change sa méthode d’évaluation de dépôts de code peut faire examiner les mêmes résultats à part. Une autre qui modifie une prévision peut comparer les résultats sur des périodes historiques mises de côté et vérifier le comportement sur de nouvelles données. Ces métiers diffèrent et gardent une responsabilité comparable. Une proposition peut arriver vite. Sa mise en production dépend de personnes en mesure de constater un résultat selon un standard connu.
La règle d’approbation devient plus utile quand les responsabilités sont précises. Un ingénieur peut juger si le gain tient dans des conditions représentatives. Les opérations peuvent s’occuper du plafond de budget et de capacité. Le responsable du produit peut vérifier que le test concerne les bons utilisateurs et définir la conduite à suivre si le changement doit être retiré. Si toutes les questions remontent à la même personne, une nouvelle file apparaît. Nommer les décisions permet de répartir le travail tout en préservant la responsabilité. Il faut aussi définir quelles pannes nécessitent une intervention humaine. L’agent peut parfois relancer un entraînement bloqué et avoir besoin d’un responsable pour reconsidérer un résultat trompeur.
Des essais moins coûteux peuvent inciter à en lancer davantage#
Meta dit que ses agents gèrent des expériences longues et aident à fixer la priorité sur les ressources communes. Cela devient un choix de gestion lorsque les équipes ont assez d’expériences pour se disputer la même capacité. Un essai moins cher libère des ressources pour d’autres, qui augmentent à leur tour la demande de planification, d’examen et de stockage. La dépense totale peut rester stable ou monter pendant que le nombre de résultats acceptés augmente. Cela peut être un résultat raisonnable. Le compte rendu ne peut pas pour autant parler d’une baisse du budget. Il faut savoir s’il s’agit de libérer de la capacité, de produire plus de changements utiles avec la même enveloppe ou de raccourcir le temps avant que l’amélioration soit disponible.
L’ordre de priorité indique aussi quels travaux pourront attendre. Meta cite l’importance pour les recettes, le potentiel attendu et l’échéance. D’autres groupes doivent peut-être réserver du temps à la fiabilité, à des catégories moins sollicitées ou à des changements futurs. Si le bénéfice à court terme décide de chaque tâche, une méthode productive aujourd’hui peut manquer de temps pour des dossiers importants dont la valeur se prévoit mal. Le responsable peut convenir des ressources mutualisées et de leur quantité, définir les décisions qui appellent une justification vérifiable et noter l’évolution des exceptions.
En pratique, le budget d’un pilote ressemble plus à une décision d’exploitation qu’à une commande d’achat. Attribuer une capacité fixe à un ensemble représentatif d’adaptations et observer le trajet complet. Noter les ressources passées dans les essais abandonnés et les raisons des changements de priorité. Comparer avec des travaux similaires dans le processus actuel. Si la nouvelle méthode économise du calcul mais que les ingénieurs règlent des responsabilités d’examen mal définies, la prochaine dépense devrait peut-être améliorer l’approbation. Si les décisions sont déjà rapides et que la capacité manque, la sélection des candidats peut être plus intéressante. Les mêmes chiffres de lancement peuvent conduire à ces deux situations sans exiger la même organisation partout.
Une diffusion commune peut aussi propager une erreur#
Un modèle type facilite la reprise d’une amélioration éprouvée et la diffusion d’une hypothèse fausse. Un changement favorable dans un groupe représentatif peut avoir un effet inattendu dans un cas qui ne se présente que sur un modèle local. Un déploiement rapide atteint ce cas plus tôt. Si les traces sont incomplètes, le comportement précédent devient plus difficile à retrouver. Des équipes qui travaillent dans plusieurs régions peuvent décider à l’avance si le premier groupe couvre les cas à forte valeur ou à risque plus faible et garder la version utilisée dans chacun. Cela conserve une bonne part du bénéfice de la réutilisation tout en aidant à isoler les problèmes.
Il est utile d’avoir des critères pour le trafic courant et pour les groupes qui risquent de réagir différemment. Une équipe de prévision peut appliquer un nouvel entraînement à une famille de magasins. L’erreur moyenne s’améliore dans les magasins habituels et augmente dans les magasins soumis à une demande saisonnière. Une diffusion plus large se justifie si l’on a assez d’éléments pour savoir à quel groupe appartient le nouveau magasin. Une règle d’arrêt donne au responsable une raison d’interrompre l’expérience avant qu’une bonne moyenne masque une perte. Les étapes et la possibilité de retour arrière laissent du temps pour apprendre si les groupes ont vraiment assez en commun.
Il reste une question d’exploitation sur la transmission des traces. L’équipe qui a trouvé une technique comprend le choix du réglage initial. Celle qui l’entretient plus tard ne voit parfois que la version en cours. Une fiche d’adaptation peut garder la technique source, la charge cible, les conditions qui la justifient, les résultats et la personne responsable en production. Si la méthode échoue plus tard, l’équipe suivante doit savoir si la première idée était inefficace ou si la mise en œuvre a changé. Des traces lisibles servent aussi aux ingénieurs et aux agents qui se fondent sur les anciens résultats.
Des responsabilités claires peuvent être plus utiles que l’envoi systématique au même comité. Les personnes qui maintiennent une configuration locale observent son comportement. Le responsable commun cherche si la même erreur survient ailleurs. Une personne précise doit pouvoir décider d’un retour en arrière et retrouver la version précédente. On peut vérifier ce chemin sur un changement sans conséquence dans le pilote. La promesse stratégique se ramène alors à une question concrète. Si la méthode change en une fois une douzaine de configurations, qui peut retrouver les endroits touchés ? Cette personne peut-elle rétablir le dernier état connu ?
Les résultats à attendre avant d’élargir le pilote#
Une équipe peut commencer avec un changement déjà validé une fois et dresser la liste des endroits où il pourrait servir. Choisir quelques cas types et au moins un cas dont la différence pourrait rendre la technique inadaptée. Garder le processus actuel pour la comparaison. Donner à l’agent accès en lecture aux traces nécessaires et relever chaque adaptation comme une décision. Examiner le travail terminé, l’attente, le calcul et l’effort de revue avec le même niveau de qualité. Si l’agent donne des idées qui échouent aux critères de mise en production, il peut avoir aidé l’exploration. Il reste à vérifier l’usage en production.
L’équipe a une raison d’élargir le pilote si le groupe retenu produit plus d’adaptations acceptées ou livre plus vite et à moindre coût avec une qualité équivalente. Il faut aussi voir qui traite les exceptions et si le résultat s’explique indépendamment de l’agent. Un gain qui résiste à un changement de composition du travail et des cas mis de côté qui se comportent comme prévu donnent de meilleures raisons de poursuivre. À l’inverse, si moins de changements viables sont repérés, si les régressions nuisibles se multiplient ou si une file d’examen perdure, réduire le champ peut être justifié. La période doit couvrir le démarrage et un cycle de déploiement ordinaire.
Le bilan de Meta donne une situation concrète à ces questions. Déployer plus vite peut avoir une valeur tout en gardant des limites fermes de calcul et d’approbation. Le rendement qu’une autre entreprise peut attendre dépend des éléments communs à ses processus, des résultats qu’elle peut réutiliser et du coût des mauvaises décisions. Les chiffres viennent d’une grande plateforme et éclairent son cas, avec des objectifs encore à atteindre. Un premier investissement raisonnable est de rendre facile à évaluer une modification qu’on exécute déjà régulièrement. Quand l’organisation sait ce qui passe et qui l’approuve, elle peut constater si un agent accélère vraiment le travail utile.