Le 19 novembre, AWS a exposé le fonctionnement et les premières évaluations des entretiens vocaux structurés d’Amazon Connect Talent. L’outil pose des questions sur le poste et peut revenir sur une réponse. Une étape ultérieure extrait les éléments comportementaux de la transcription et évalue les compétences selon des critères définis. Un cabinet de psychologie du travail mandaté par Amazon a examiné 36 entretiens et identifié 252 éléments de grille. AWS rapporte un accord de 89,3 % avec les évaluateurs sur ces jugements. Le résultat justifie un examen contrôlé. Il mesure la proximité entre les jugements du logiciel et ceux des experts sur les mêmes entretiens. Il ne dit pas comment l’outil prédit les performances dans un poste, qui éprouvera des difficultés ou quels effets apparaîtront lorsqu’on utilise le score pour décider. Évaluation publiée par AWS
Pour l’achat, je testerais le produit comme moyen de recueillir et d’organiser des informations sur un poste défini. L’intérêt dépend de la pertinence des questions, de ce qu’un lecteur peut comprendre d’une note contestée et de la réponse de l’employeur à un obstacle dans l’entretien vocal. Une entreprise qui ne sait pas définir la compétence ou examiner la note a du travail à faire d’abord. Le tarif d’un entretien supplémentaire est facile à trouver. Les conséquences d’un refus injuste ou d’un enregistrement inexact restent à la charge de l’organisme qui recrute.
L’évaluation de novembre suit le lancement du produit#
AWS a annoncé la disponibilité générale le 16 septembre, alors dans les régions américaines de Virginie du Nord et d’Oregon. L’article de novembre décrit la conception et les essais. Il passe d’une description des fonctions à des éléments sur la façon dont le logiciel utilise les méthodes d’entretien. La distinction aide l’acheteur. Un service peut être disponible tout en soulevant des questions de performance. Le cas expose les arguments d’AWS pour des affirmations précises. Il ne suppose pas la même expérience dans tous les pays, langues et marchés de l’emploi. Il faut situer l’essai dans une région et un processus. Annonce de disponibilité d’AWS en septembre
L’entretien structuré existait avant ce produit. Les évaluateurs conviennent de questions liées au poste, demandent des exemples comparables et utilisent une grille au lieu de juger la conversation entière sur une impression. Une méta-analyse publiée par Sackett et ses collègues en 2022 examine la validité de différentes méthodes. Les entretiens structurés se classent haut dans les comparaisons révisées, même si les auteurs jugent que plusieurs anciennes estimations étaient trop élevées. Cela donne une raison de s’intéresser à la structure. Il reste à savoir si le produit offre une occasion comparable de montrer une aptitude réellement utilisée au travail. Les résultats généraux ne répondent pas seuls à cette question. Étude de Sackett et ses collègues
La structure doit commencer par les exigences du poste#
Connect Talent s’appuie sur les descriptions de poste et des cadres de métiers pour générer les compétences, les questions et les critères d’évaluation. Le recruteur peut les vérifier et les modifier. La conception donne une matière concrète à examiner. Elle peut aussi rendre une mauvaise description de poste plus détaillée et cohérente, donc moins facile à repérer. Une question sur le suivi des clients peut convenir à un poste et être sans intérêt pour un autre. L’employeur a besoin d’une personne qui connaît le travail et peut expliquer ce que révèle la réponse et comment elle sera utilisée. L’entretien commence par cette décision.
Selon l’examen commandé, 91 % des compétences générées dans l’échantillon pouvaient être reliées clairement à la description du poste, 98 % des questions visaient la compétence voulue et 94 % des indices mesuraient clairement cette compétence. Ces résultats portent sur des contenus générés avant révision humaine et sur des unités distinctes. Ils ne disent pas si la prochaine description de poste est juste ou ce que peut coûter une question mal choisie au candidat. L’équipe peut les prendre comme raison de tester le mécanisme et conserver une approbation humaine compétente des questions finales.
Il faut rapprocher les questions du poste pour une autre raison. Une compétence peut rester trop large même si toutes les questions lui correspondent. Un poste demande peut-être de documenter une décision quand l’information change. L’entretien peut chercher un exemple de ce comportement et accepter plusieurs bonnes réponses selon les expériences. Un objectif comme « paraître décidé » peut récompenser une façon de parler. Une tâche précise permet de voir si la réponse montre ce que le travail exige. Elle donne aussi une raison de modifier une question qui commencerait à mesurer un autre facteur.
Séparer la conversation du score permet une vérification#
AWS distingue le dialogue et l’évaluation. L’outil mène l’entretien et relance si nécessaire. Une étape suivante repère un comportement, cite des extraits et calcule une note de un à cinq. Quand les preuves sont insuffisantes, le service signale la compétence sans la noter. La différence avec un classement général est pratique. Le recruteur peut lire le passage et vérifier si le jugement en découle. Le principal intérêt est que l’on peut corriger le résultat. Une personne chargée de la vérification doit avoir accès aux éléments et le droit de ne pas suivre la note.
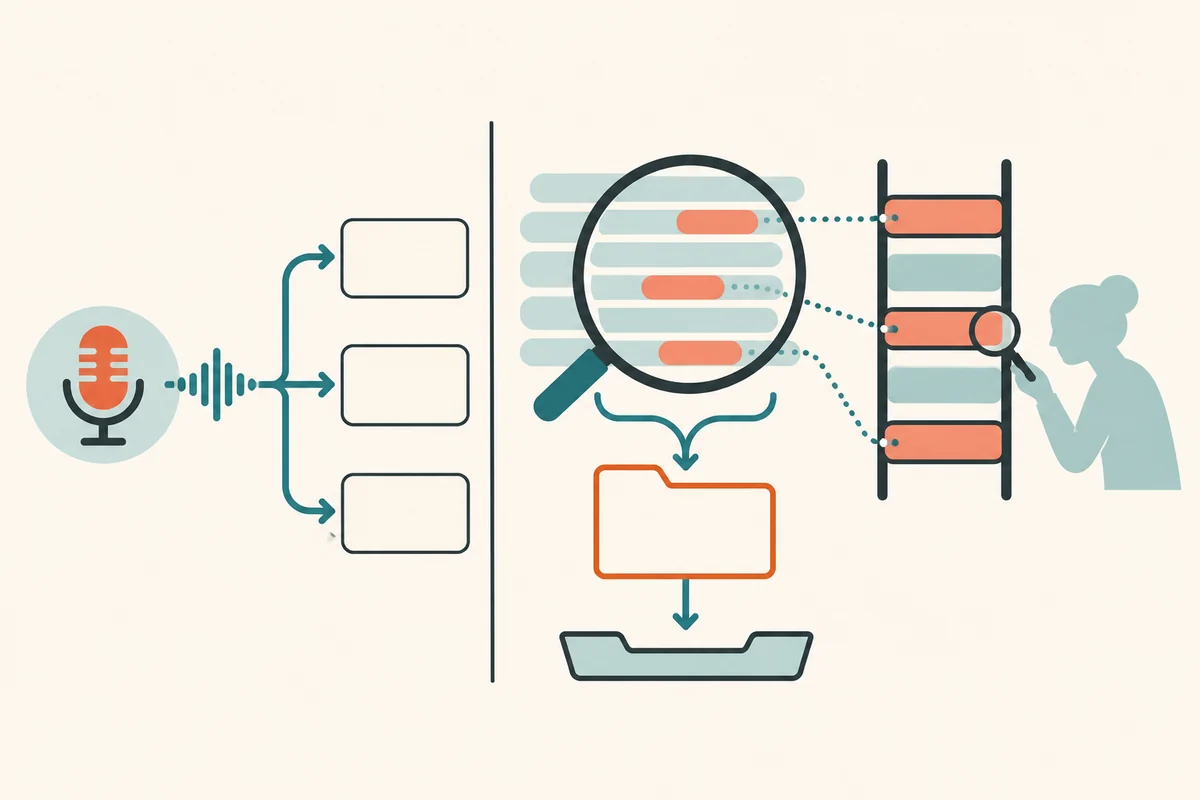
Le signalement des preuves insuffisantes est important car les omissions ont plusieurs raisons. Une question peut manquer de clarté, la connexion peut tomber, ou le candidat peut raconter un cas sans préciser sa contribution. Ces situations ne montrent pas la même chose qu’un échec au travail. L’employeur doit distinguer un entretien qui demande des éléments d’une décision déjà prise. Sinon un système de recrutement en aval peut convertir une valeur vide en résultat défavorable sans lecture de la transcription. Une question ouverte a besoin d’un responsable et d’une procédure pour compléter le dossier sans exclure le candidat entre-temps.
Dans sa comparaison préliminaire, AWS constate jusqu’à 1,14 point de moins sur cinq pour les évaluations qui ne prennent que la première réponse, par rapport à celles qui utilisent toute la conversation. C’est une différence maximale dans cet essai, pas une moyenne ni un gain pour tout le monde. Elle appuie l’idée que de bonnes relances font apparaître des éléments manquants. Leur contenu a toujours son importance. Une relance peut aider à mieux décrire un résultat ou changer de longueur, de précision et d’interprétation selon le cas. Il faut voir comment les questions évoluent et si chacun a eu une occasion comparable de répondre.
L’accord est utile dans les limites de son dénominateur#
Le chiffre le plus repris sera probablement 89,3 %. AWS l’associe à l’accord avec les résultats d’un cabinet extérieur sur des indices provenant de 36 entretiens. L’entreprise indique 97,6 % dans les cas où les éléments étaient clairs et un kappa de Cohen de 0,79. Le kappa tient compte de l’accord attendu par hasard, particulièrement utile quand une catégorie est très courante. Ces données décrivent les cas testés. Elles ne constituent pas un taux de réussite du recrutement ni une mesure du taux d’erreur sur les 1 000 candidatures suivantes et leurs groupes. Les cas clairs donnent un point de comparaison, précisément parce que le travail de vérification devient plus difficile dans l’ambiguïté.
Comprendre les désaccords importe aussi. Le passage permettait-il deux interprétations raisonnables ? Le programme a-t-il ignoré une référence claire ? Manquait-il des mots dans la transcription, ou la question ne pouvait-elle pas faire ressortir l’aptitude voulue ? Un ensemble représentatif de désaccords peut être plus révélateur qu’une décimale de plus dans le taux global. Le responsable comprend où une personne peut réellement améliorer le jugement. L’acheteur peut demander comment l’échantillon a été constitué et si son équipe peut examiner le prochain groupe sous des critères convenus.
AWS indique aussi que le procédé structuré a utilisé les cinq niveaux de notation lors de la comparaison, tandis que le jugement global utilisait surtout les trois notes du milieu. Un étalement est utile s’il traduit une variation qui a du sens. Pour chaque écart, l’évaluateur doit voir en quoi la réponse et la règle justifient deux notes différentes. Sinon un deux ou un quatre donne une impression de précision et peut orienter un dossier différemment pour une raison faible. Une autre étude peut vérifier si les écarts expliqués correspondent à un résultat lié au poste et s’ils demeurent avec plusieurs équipes et au fil du temps.
Il faut tester l’accès des candidats dans les situations réelles#
AWS dit utiliser les réponses transcrites pour noter les compétences, sans vidéo, ton de la voix, apparence ou identité du candidat. Cela donne un choix précis à vérifier. Il reste à comprendre comment on obtient la transcription. Un outil vocal peut perdre des mots, mal traiter un environnement bruyant ou poser une question inattendue. Une transcription bien notée peut venir d’un entretien que certains candidats ont eu du mal à finir. Un employeur doit considérer l’accessibilité et les formats alternatifs dans le processus et regarder comment les scores sont utilisés avec ces options. Il faut une voie d’assistance avant qu’une difficulté de format devienne un désavantage ignoré. Ressources de l’EEOC sur l’IA et l’accessibilité du recrutement
L’étape suivante doit être compréhensible pour le candidat. Il faut pouvoir savoir qu’un entretien automatique a lieu, ce qui est recueilli et qui joindre en cas de panne ou de demande d’un autre format. L’opérateur doit pouvoir expliquer quelles questions seront notées et examiner un signalement de transcription erronée. Ces choix s’appliquent même lorsque le fournisseur propose un portail. Un responsable peut désigner qui répond afin que l’autre voie ne devienne pas, en pratique, plus lente ou moins considérée. On peut faire ces vérifications sans supposer qu’une fiche commerciale établit la conformité partout.
Il faut observer les étapes qui précèdent le score. On peut relever les invitations sans réponse, les sessions inachevées, les demandes d’aménagement et les suites données, avec un cadre approprié. Seules les personnes qui terminent entrent dans une comparaison de transcriptions achevées. Celles qui ne peuvent jamais se servir du matériel demandé disparaissent du dénominateur. L’accès et les résultats des méthodes alternatives renseignent sur le public que le processus atteint. La cohérence doit couvrir la possibilité de répondre et le jugement porté sur les réponses reçues.
Le budget couvre plus que la facture calculable#
AWS affiche 20 dollars par évaluation complète, qui comprend l’entretien par IA et l’évaluation du candidat. Mille évaluations combinées achevées donnent 20 000 dollars au tarif publié, avant le travail de préparation, d’examen et d’assistance. Selon la page, AWS ne facture pas à l’employeur les évaluations que le candidat ne termine pas. L’incident prend néanmoins du temps à ce dernier et peut nécessiter un recruteur. Une entreprise doit comparer tout le coût d’un résultat utile et vérifié à sa procédure de départ. Le tarif rend une partie du calcul claire. Il ne paie pas l’examen que la procédure entraîne. Tarif publié par AWS
L’achat porte aussi sur les enregistrements, les transcriptions, les évaluations et les documents fournis. Le guide AWS indique par défaut la suppression des transcriptions, notes et dossiers de candidature un an après leur création. Des durées différentes se demandent auprès du support. Si l’employeur exporte une fiche ou envoie l’évaluation dans un autre système, des copies peuvent subsister sous d’autres règles. Il faut fixer qui garde les documents et qui peut les voir à chaque étape. Un cycle de conservation interne à un service ne permet pas de conclure sur toutes les copies. Documentation AWS sur la conservation
L’employeur peut comparer la technologie à un changement plus modeste. Des recruteurs peuvent obtenir de meilleurs éléments avec des questions cohérentes et du temps pour comprendre les désaccords. Un service vocal peut ouvrir davantage de créneaux, ce qui a de la valeur si les humains manquent de temps. Le meilleur achat dépend du problème actuel. Collecter plus vite aide si la vérification fonctionne et dispose des moyens nécessaires. Sans temps pour lire, une collecte plus large donne plus de documents à laisser de côté. Le budget doit désigner l’étape visée et la personne qui effectuera le travail supplémentaire.
Le prochain évaluateur doit pouvoir retrouver le raisonnement#
Le dossier du candidat peut rester après le modèle, la version et le recruteur qui l’ont produit. Un examen doit retrouver les questions en vigueur, les passages cités et la personne qui a repris la décision. La grille actuellement affichée pourrait induire en erreur si les règles ont changé. Il faut garder assez de contexte avec l’évaluation pour savoir quelle règle a été appliquée et si une personne l’a corrigée. La condition reste importante même lorsque le prestataire améliore son système. La qualité de la version actuelle n’explique pas le sort d’une candidature le mois précédent.
Un changement de grille ou d’intervieweur mérite un examen propre. L’acheteur peut demander comment le fournisseur décrit les versions et quelles informations des dossiers précédents restent lisibles. L’employeur peut également décider quand des responsabilités différentes imposent de nouvelles questions. Ces deux raisons de modifier le processus peuvent appeler des approbations différentes. Dans un cas, il peut s’agir d’un progrès logiciel vérifié. Dans l’autre, le sens d’une compétence change pour l’employeur. Sans traces, il devient difficile de comparer les résultats ou de retrouver une ancienne décision dans la nouvelle interface.
On peut nommer trois responsabilités. Le responsable du poste approuve les comportements concernés. Le recruteur vérifie si les preuves soutiennent le résultat et peut relever un désaccord. Le responsable du service traite les problèmes d’accès et trouve une solution de remplacement. Une petite organisation peut confier plusieurs tâches à la même personne, à condition qu’elle se sache responsable. Les rôles rendent une destination visible. Une personne qui signale un passage inexact peut atteindre quelqu’un capable de le vérifier et le corriger, sans être renvoyée à un écran de notation.
Mesurer le travail économisé et celui qui change d’endroit#
On peut accélérer l’entretien tout en ajoutant des tâches ailleurs. Les recruteurs peuvent passer moins de temps à trouver un créneau et davantage à expliquer un résultat inattendu. Un responsable reçoit un texte plus long et cherche plus longtemps les passages pertinents. Les candidats apprécient un choix d’horaires et peuvent regretter qu’une panne n’obtienne pas de réponse. L’acheteur peut noter ces effets séparément pour distinguer le délai, le temps de travail et la qualité de la preuve. Le prix donne un nombre de sessions. Leur intérêt dépend de leur contribution à une décision dont quelqu’un répond.
Il faut aussi compter les situations qui coûtent parce qu’un problème est arrivé. Un entretien à refaire, une interprétation à faire vérifier et un autre format à mettre en place en font partie. Garder ces exemples lors du pilote permet de comparer le soutien demandé à la procédure utilisée aujourd’hui. L’évaluation terminée sert d’unité de facturation. Le recrutement a besoin d’un parcours qui aboutit à une décision claire et révisable. L’essai doit montrer si la différence peut s’expliquer aux responsables et aux candidats.
Essayer avant de laisser le score influencer le recrutement#
L’employeur peut d’abord faire comparer des résultats sur des cas autorisés sans utiliser les notes automatiques pour décider. Définir les critères liés au poste, les résultats inacceptables et le traitement des désaccords. Prévoir une évaluation humaine comparable et les éléments complets pour la relire. On peut inclure des réponses ambiguës, des interruptions et des formats alternatifs. C’est là que le format vocal peut demander le plus de travail. Vérifier si la personne retrouve les preuves et voit quand le passage n’établit pas le comportement attendu. On apprend ainsi ce que mesure le système sans faire dépendre les candidatures d’un nouveau score pendant le test.
L’exercice a besoin d’un arrêt possible. L’employeur peut suspendre l’essai si des obstacles ou des écarts inexpliqués apparaissent, et nommer la personne qui réexamine les dossiers. Il doit aussi savoir comment la procédure continue si le service manque. Si la vérification devient plus facile et que les éléments restent utiles en situation réelle, un essai limité avec supervision peut se discuter. Il faut garder du temps pour les suites et conserver les cas de désaccord avec le logiciel. Le prochain groupe pourra juger si les gains d’organisation et de cohérence valent le coût.
La nouvelle publication d’AWS renforce la possibilité d’examiner une conversation structurée. Elle donne une unité de coût, des résultats de vérification et une documentation d’exploitation. La décision appartient au contexte de l’employeur. Une personne doit répondre de l’avancement ou du refus et pouvoir examiner les preuves lorsqu’une réponse manque ou qu’un candidat soulève un problème. L’outil mérite un essai s’il s’agit d’obtenir une meilleure trace d’un entretien défini. Pour donner davantage d’autorité aux notes, il faudra des preuves venant du travail réel et des personnes qu’il atteint.