18 ноября AWS запустила межрегиональную маршрутизацию вывода SageMaker AI и опубликовала случай её применения во внутреннем шлюзе Salesforce. Сервис может выбирать из уже развёрнутых точек в разных регионах и учётных записях. Salesforce сохраняет запросы, для которых действует требование к месту обработки, в исходном регионе. Другие запросы могут обратиться в разрешённое место, если местная точка испытывает трудности. Это полезно компании, которая уже запустила одну модель в нескольких регионах с неравномерными запасами. Польза зависит от того, понятно ли, какие запросы можно переносить, кто выделил принимающую мощность и как проверить фактический маршрут. Случай Salesforce и AWS
У испытания есть важное ограничение. При перегрузке задержка росла несколько минут, пока вызовы оставались в исходном регионе. Поток начал переходить после появления ошибок. Это полезный пример распределения мощностей по правилам. Для бизнеса остаётся отдельный вопрос о том, сколько человек может ждать срабатывания этих правил. Стоит оценивать сервис как способ передать часть маршрутизации поставщику. Компания сохраняет ответственность за допуск, точки обработки, восстановление и связь с клиентами. Услуга выбора назначения не решает, что допустимо в запросе и за какое время нужно получить результат.
Тридцать с лишним регионов объясняют проблему, а не масштаб внедрения#
Команда Agentforce Foundation Salesforce описывает обслуживание моделей более чем в 30 регионах с множеством аккаунтов AWS. Это масштаб существующего сервиса. Опубликованный тест маршрутизатора уже, а расширение обозначено как следующая работа. Это различие важно при чтении отчётов клиентов. Большая компания может объяснить задачу, не проверив новый способ везде. В Salesforce пики и приход новых пользователей создают дефицит в одних местах и запас в других. Резерв на все совпавшие пики в каждом регионе может дорого стоить. Общие мощности помогут части работы, если запросы и принимающие площадки допущены к участию.
Традиционно переключение приходится поддерживать в приложении или шлюзе. Salesforce пишет, что прежний шлюз выполнял проверки состояния, повторные попытки и смену регионов, однако не видел полной картины мощности в начале и конце маршрута. Команда хотела ограничить последствия переноса нагрузки во время сбоя. Часть логики можно перенести в облачный сервис, сократив объём сопровождения в каждом приложении. При этом меняется способ наблюдения и проверки. Руководителю полезно спросить, что отдали поставщику, какие правила остаются у компании и какие аварии всё ещё нужно репетировать. Эти обязанности сохраняются при упрощении вызова.
При запуске AWS указала 32 коммерческих региона для вывода в реальном времени и 25 для асинхронного. Эти показатели описывают охват поставщика, отдельно от масштаба Salesforce и её испытания реального времени между двумя регионами. Они помогают найти доступную услугу, не создавая точки в аккаунте покупателя. Решение начинается с тех моделей и регионов, которыми компания уже управляет. Второй регион с неподходящей моделью или без свободных ресурсов не становится резервом только потому, что его название есть в договоре. Сообщение AWS о запуске
Допустимость определяют до выделения мощности#
Внутренний шлюз Salesforce проверяет требование к месту обработки до передачи в межрегиональную схему. Для запроса с ограничением существует только местная точка. Остальные могут уходить в заранее разрешённые места. При сбое категории ведут себя по-разному. У первой меньше возможных назначений, а при перегрузке может не остаться запаса. Вторая пользуется свободными ресурсами другого региона. Общий показатель доступности может скрыть людей без разрешённого резерва. Покупателю нужно понимать, что он может предложить обеим категориям пользователей.
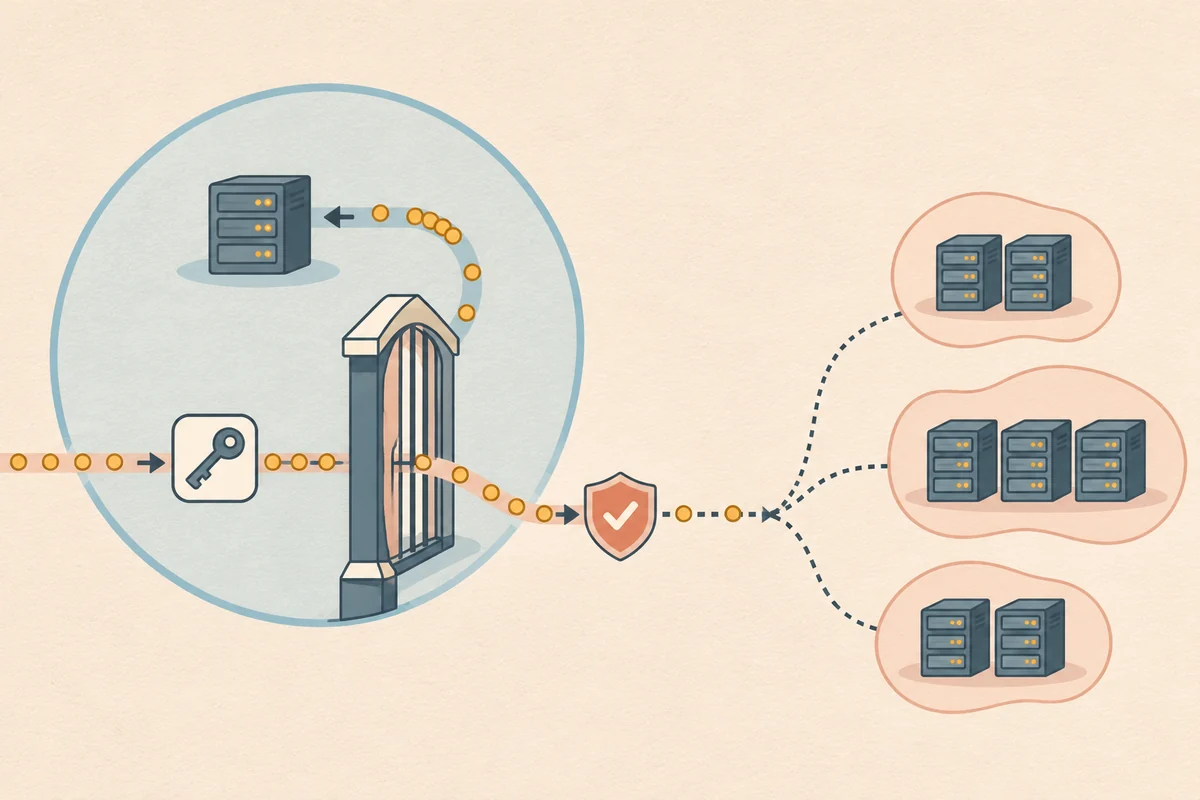
Политику компании нельзя взять из меню выбора региона. Договор может определить, какие сведения или нагрузки должны оставаться внутри определённой границы. Команда переведёт это в список разрешённых мест и реакцию при недоступности. Два сервиса из одного региона могут жить по разным правилам. Один работает с разговорами клиентов, другой с обобщёнными примерами, для которых разрешён другой маршрут. Владелец приложения должен определить правило для каждого запроса и сохранить основание. Мощности можно гибко распределять внутри границ, которые заказчик способен объяснить.
Стоит выяснить, что произойдёт, если допустимость не указана или сведения противоречат друг другу. Для одной нагрузки правильным будет остаться на месте или остановиться, для другой может существовать согласованный широкий список. Решение исходит из обязательств, а не текущего числа запросов. Такая неопределённость возможна при запуске или изменениях входных данных. Случай Salesforce убедителен тем, что фирма держит видимое бизнес-правило в шлюзе и делегирует остальные действия. Покупатель должен определить, какое правило останется в его приложении.
Принимающей точке нужен собственный бюджет ресурсов#
Маршрутизатор отправляет запросы только к уже работающему ресурсу клиента. Он не устанавливает модели, не копирует их файлы и не поднимает экземпляры. Владелец точки решает вопрос с мощностью, даже если маршрутизатор оперирует кто-то ещё. Занятый регион, принимающий всё от соседнего, может расширить сбой. AWS предлагает дополнительный предел для межрегионального потока на точках реального времени, чтобы оставить место местным запросам. Он помогает, если стороны могут согласовать, сколько отдать другим, и затем проверить поведение при достижении предела.
Бюджет состоит из мощности на собственный пик и места для работы из другого региона. Пики могут происходить в разное время или совпадать. Спокойный регион нередко служит хорошим резервом для известной перегрузки, но помогает меньше, когда тот же инцидент увеличивает спрос в двух местах. Salesforce оставила оценку каскадного эффекта на предельном потоке на этап перед расширением. Команде нужно проверить обычный режим и неудачное совпадение пиков, прежде чем строить обещания доступности на общей мощности.
При работе между аккаунтами нужно договориться об ответственности. В случае Salesforce политика точки разрешает доступ определённому маршрутизатору и сохраняет решение у владельца точки. Он должен видеть ответственных, утверждённые пути и момент, когда доступ разрешено изменить. Во время сбоя полезен человек, который может назвать допустимый внешний объём и последствия для местных пользователей. Общий сервис упрощает вызовы. Договорённость команд, которые предоставляют и потребляют мощности, всё ещё нужна. Документация AWS о защите данных при маршрутизации
Время в отчёте Salesforce относится к одному испытанию#
Salesforce, по отчёту, загрузила точку в Орегоне до насыщения и одновременно наблюдала отдельные контрольные запросы. Около пяти минут медианная задержка выросла с 0,2 секунды примерно до 45–58 секунд, а поток оставался в Орегоне. Одна задержка не вызывала перехода. После истечения времени обработки в контейнере появились ошибки. Примерно через две минуты после первых ошибок отдельные запросы дотянулись до Огайо. Ещё через минуту там обслуживалось примерно 78 % контрольного потока. Этот порядок объясняет, почему момент срабатывания важен не меньше резерва. Описание выбора направления от AWS
После переноса медиана вернулась примерно к 0,2 секунды. В этой конфигурации межрегиональный путь добавлял менее 100 миллисекунд на медиане. После восстановления трафик возвращался постепенно около десяти минут. По отчёту, контрольные запросы не фиксировали ошибок во время переключения и возврата. Это результат пробы, отдельно от ошибок на загруженной точке и другого возможного опыта. Запас и задержки отличаются в разных местах. Покупателю стоит выбрать, какую часть повторить, а не вписывать эти числа в каждое новое соглашение.
С точки зрения продукта минуты до переноса могут значить больше быстрой работы после. Интерактивное приложение может потерять людей, которые уже устали ждать. Пакетная операция может надёжно ждать дольше и избегать переноса в другой регион по одной медленной реакции. Руководитель определяет, что увидит пользователь и что сможет сделать в период проверки состояния. Отчёт показывает начало и конец этого периода в испытании, оставляя пользовательский опыт у приложения.
В записи нужны место обработки и причина выбора#
По отчёту Salesforce, шлюз записывает обслужившую точку и причину выбора вместе с идентификатором запроса. AWS публикует общие метрики направлений в CloudWatch. Это помогает отличить обычные местные операции от перемещённых после ошибок. Команда может использовать тот же принцип для анализа. Наблюдение должно показать действие правил и их соблюдение, а не только скорость. Владельцу стоит знать, где был обработан определённый запрос и к кому обратиться при неожиданном результате. Руководство AWS по мониторингу маршрутизатора
Запись адреса и причины не требует широко показывать введённый текст. Идентификатор, утверждённая точка и основание помогут расследовать случай, а детали можно открывать по необходимости с ограниченным доступом. Записям всё равно нужны срок хранения и ответственный. Можно заранее определить, как проверять правильность выбора. Разрешённые тестовые запросы дают сравнение истории отправления и обработки с правилом. Панель должна показывать объём и ошибки. Отдельная запись позволяет ещё раз проверить решение об одном запросе.
В записях будет виден и вопрос версий. После обновления регионы могут запускать разные варианты модели, контейнеров или файлов. Маршрутизатор может выбрать точку, не сделав её тождественной другой. Когда ответы отличаются, восстановленная доступность может соседствовать с ухудшенным качеством. Команда может проверять сопоставимость на утверждённых примерах до допуска внешнего потока. Можно записывать версии и предусматривать, что делать при разном темпе обновлений. Платформа даёт место для вызова. Компания утверждает, какие места могут отвечать на один и тот же вопрос.
Отсутствие дополнительной цены меняет одну строку расходов#
По объявлению, отдельной платы за маршрутизацию нет. Точки SageMaker и метрики CloudWatch остаются на стандартных тарифах. Организация может поставить рядом резерв, время проверки моделей в разных регионах, поддержку, наблюдение и остальные расходы своей архитектуры. Проект выгоднее, если полезная работа использует ресурсы, которые иначе простаивали. Он слабее, если принимающий регион резервирует почти столько же, сколько при местном резервировании, а у команды значительно растёт труд на классификацию и проверку. В объявлении есть основание для сравнения, но не счёт конкретной компании.
Две схемы можно сравнить по цене успешного ответа за приемлемое время. Записать нормальные направления, повторные вызовы и мощность, которая по-прежнему нужна на месте. Финансовый руководитель свяжет расходы с теми запросами, которые действительно выигрывают. Местная категория может требовать отдельного вложения, нельзя переносить на неё экономию других. Общий резерв полезен при разных пиках. Если они совпадают, каждой площадке может понадобиться запас на одно и то же трудное время. Маршрутизация меняет использование мощности, а покупатель всё ещё решает, сколько брать.
В бюджет входит тот, кто вмешается при проблеме. Переход на сервис поставщика может убрать повторный код из нескольких приложений. Надо научиться видеть причины, метрики и способы управления под нагрузкой. Без репетиции время разработки можно заменить поиском причины более далёкого решения. Если владельцы приложения видят перемещение, справляются с ошибками и выполняют обещания клиентам, работы действительно станет меньше. Покупатель может назвать ответственных за начальный запуск, регулярную проверку и целевые точки, затем сопоставить это с действующей нагрузкой.
Приемлемый сервис нужно определить во время сбоя и после него#
Полезное обязательство указывает, что получит человек, когда допустимый запрос работает медленнее ожидаемого. Веб-приложение может показать состояние и предложить другое действие, если быстрого результата не будет. Плановая обработка может дождаться завершения или явного сообщения об ошибке. Это разные схемы обслуживания с одним маршрутизатором. Руководитель может измерять время ожидания, последствия обрыва и связь задержанного ответа с исходным запросом. Короткая линия восстановления не покажет это, если приложение не собрало сведения.
Важна граница повторов. Согласно отчёту, маршрутизатор повторяет некоторые ошибки один раз, если модель не успела обработать вызов. Шлюз Salesforce не добавляет свои повторные попытки на этом пути. Нужно понимать, какая попытка дала результат и будет ли вызывающая сторона повторять их ещё. Повторение работы повышает нагрузку на приём именно в момент общего использования. Для клиента с жёсткими ограничениями качество состоит в получении результата без неожиданных повторов и очередей на каждом уровне. Оно зависит от поставщика и настроек приложения.
Нужно заранее согласовать и смысл восстановления. Когда основной ресурс вновь здоров, управляемая служба постепенно возвращает вызовы домой. Пока движение разворачивается, местные пользователи принимающей точки ещё делят мощность. Командам нужно видеть, вернулись ли обычный поток и расходы, и знать, кто может остановить расширение при изменении картины. Ещё до опыта можно решить, кто следит за исходной точкой, кто за принимающей и кто сообщает владельцу продукта об окончании. Управление остаётся нужным даже без человека, вручную переводящего запросы.
Соглашение должно охватывать дефицит в обеих точках. Каждая команда может назвать объём, который готова дать, и порядок при достижении ограничения. Более низкий предел сохраняет местный сервис и оставляет меньше для соседей. Более высокий способен исправить одну аварию и замедлить других. Стоит проверить оба варианта и указать, кто меняет ограничение. Это не даёт видимому восстановлению первой программы скрыть расход принимающей. Решение можно пересмотреть при изменении трафика после запуска нового продукта.
Малый тест должен проверить и оправданный отказ от переноса#
Можно начать с одной модели и двух уже допустимых точек. Использовать тестовые данные, разрешённые для обеих, сопоставить ответы и определить объём приёма любой из них. В тестовой среде имитировать сбой местного ресурса и проверить направление подходящих запросов. Затем отдельно проверить местную нагрузку, чтобы ошибка не привела к неразрешённому адресу. В упражнение стоит добавить нехватку мощности везде и восстановление точки. Важно выяснить, какие состояния способна обработать организация, а не только увидеть один удачный перенос.
Перед расширением стоит держать на виду время деградации, частоту ошибок, возврат и последствия для обычных пользователей принимающей точки. К отчёту нужно приложить условия, чтобы руководитель мог объяснить, какое обещание проверено. Владелец должен знать способ остановить маршрутизацию шире и понять, что увидит клиент без приемлемой точки. Сервис стоит испытать при неравномерной нагрузке и нескольких подходящих местах. Вывод изменится, если тест покажет регулярное ожидание до переноса, давление на принимающий регион или неспособность подтвердить местную обработку. Это важнее успешного соединения на демонстрации.
Случай Salesforce и запуск AWS дают основание рассматривать свободную мощность как ресурс, которым компания делится по плану. Основные решения видны до вызова маршрутизатора и после него. Организация утверждает категории и места, команды готовят точки, ответственный проверяет путь после изменения. В сочетании с управляемым сервисом это может упростить работу. Расширение заслуживает доверия, когда есть доказательства соблюдения обещаний о месте и времени обработки.